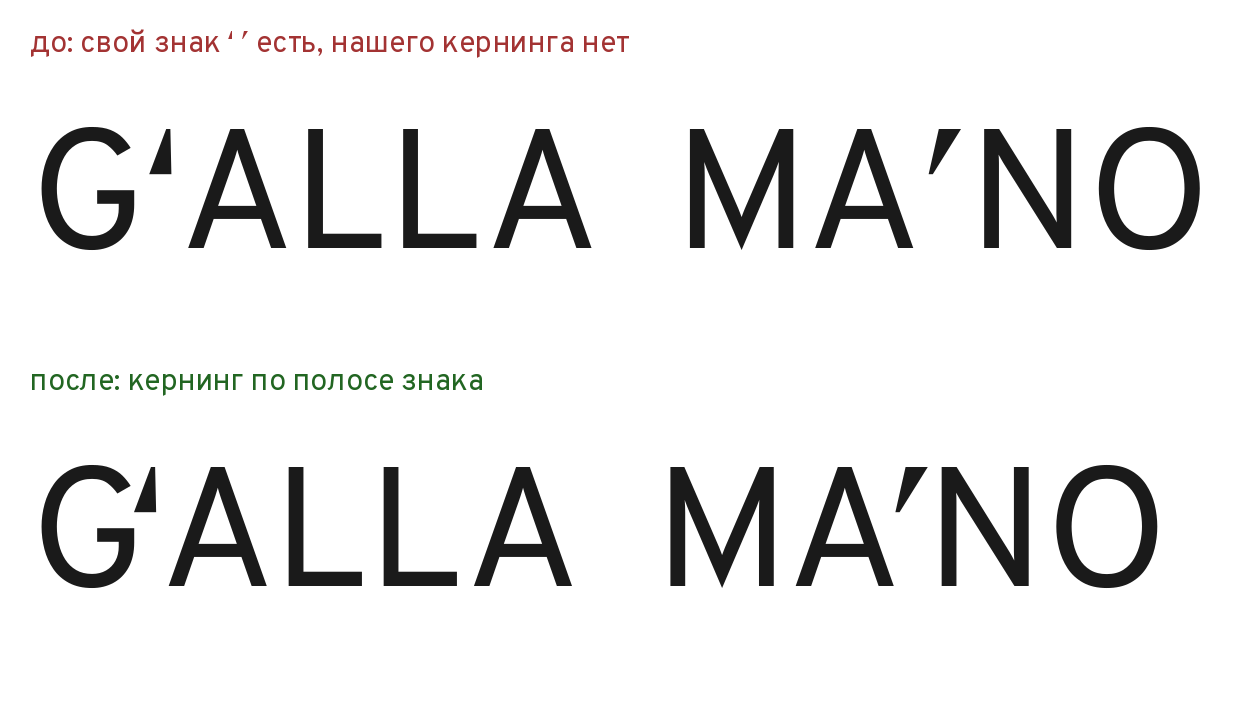
El signo ʻ es pequeño. Va arriba, a la altura del tercio superior de la letra mayúscula, y debajo de él hay vacío hasta la línea. Mientras el signo está rodeado de letras redondas, eso casi no se nota. Pero póngalo entre G y A — y en la palabra GʻALLA aparece un hueco.
En este artículo: cómo le hicimos frente en la tipografía de trabajo Ipak Davlat y por qué el método de alineación corriente no funciona aquí. Las correcciones de distancia para pares sueltos de letras se llaman kerning.
De dónde sale el hueco
Mire la línea superior de la imagen. El signo ʻ se aparta de la G y después viene todavía otro hueco hasta la A. La A es puntiaguda arriba: también ella da mucho aire. Tres vacíos se suman en uno y la palabra se parte en «G» y «ʻALLA».
Con el tutuk ʼ en MAʼNO pasa lo mismo: la A está abierta arriba a la derecha, el ʼ es estrecho y la N empieza con un asta vertical. Entre A y N se forma una ranura más ancha que entre cualesquiera otras letras de la palabra.
De este problema en la composición uzbeka advierte el panorama de type.today: el intervalo entre O o G y el signo ʻ no debe ser demasiado grande; si no, en el texto aparecen huecos.
Cómo se ponen normalmente las distancias
La comprobación de pares por computadora que escribimos para Ipak funciona igual que los «espaciadores» automáticos: programas que colocan los márgenes. El par de letras se corta en líneas horizontales desde la línea base hasta el tope de la mayúscula. En cada línea se mide la distancia blanca desde el borde derecho de la letra izquierda hasta el borde izquierdo de la derecha. El promedio de todas las líneas es el hueco óptico del par. Óptico porque así lo evalúa el ojo, no la regla.
Los hundimientos profundos, como el interior de la L o el espacio bajo la barra de la A, se recortan: el ojo no mira hasta el fondo de ellos.
El patrón es el hueco del par HH. Dos astas rectas son el caso más simple, y los márgenes de la base los consideramos correctos.
Por qué esto no funciona con el signo
El signo ocupa solo la parte superior de la línea. Debajo de él no hay nada. Si se mide en toda la altura, al promedio entra el vacío bajo el signo, y ese es grande. El algoritmo ve un «hueco enorme» y acerca el signo hasta pegarlo o incluso lo mete bajo la letra vecina.
Nuestra primera versión hizo justamente eso: el signo se montó sobre la A. Suavizamos la regla — y el signo «saltó»: se pegó a la A y pasó a leerse como parte de ella, no de la G. El lector veía «G ʻA».
Ambos errores vienen de una sola causa: el hueco se medía donde el signo no está.
La banda del signo
La solución es medir solo en la banda donde el signo realmente está. En Ipak Davlat, el signo ʻ ocupa el 38 % superior de la altura de la mayúscula. Esa es justamente la banda que tomamos.
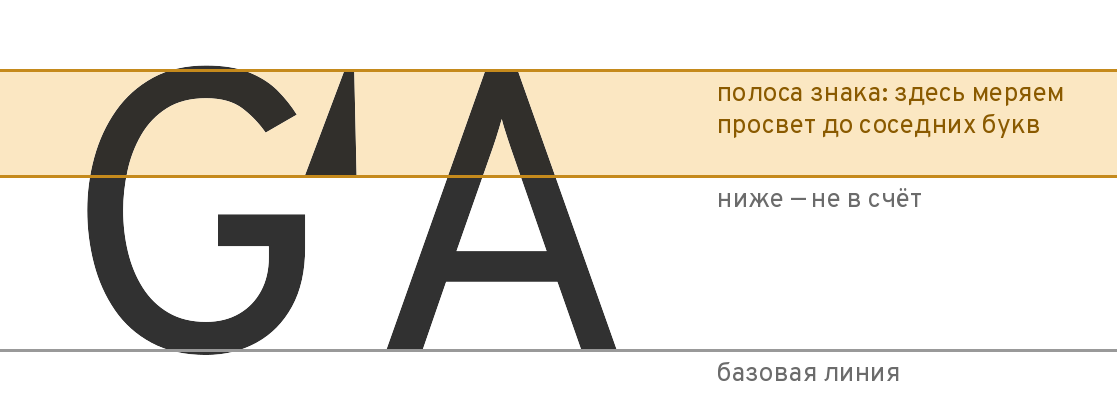
En la banda se ve lo que ve el ojo a la altura del signo: el borde derecho de la G, el signo mismo, el borde izquierdo de la A. El vacío bajo el signo no entra en el cálculo.
Para las minúsculas, la banda es más ancha: desde la mitad de la altura de la x minúscula hasta el tope de la mayúscula. Las minúsculas son más bajas y el signo sobresale sobre ellas.
La regla asimétrica
El segundo hallazgo: el signo necesita distancias distintas a cada lado.
El ʻ pertenece a O y G. No es un símbolo aparte, sino parte de la letra. Por eso, con ellas el signo se coloca apretado: la meta es 0,45 del hueco normal de HH. Y hasta la letra siguiente, el hueco normal, 1,0. Así la Gʻ se lee como una sola letra y el signo no «salta» hacia la A.
El ʼ separa sílabas. No es de nadie: no pertenece ni a la letra izquierda ni a la derecha. Por eso se coloca justo en medio, a 0,8 del hueco por ambos lados.
Otras dos restricciones protegen de los extremos. En el punto más estrecho, el signo no queda más cerca de 0,4 del hueco de HH respecto a su vecino. Y ningún par de la tipografía queda a menos de un 5 % del cuerpo: es la protección contra los toques. El cuerpo es el tamaño de la tipografía; un 5 % del cuerpo son 5 mm para letras compuestas a 10 cm.
Nuestra medición antes y después, Ipak Davlat Regular, en fracciones del hueco de HH, en la banda del signo:
| Par | Sin nuestro kerning | Con él |
|---|---|---|
| G → ʻ | 1,16 | 0,69 |
| ʻ → A | 1,12 | 0,99 |
| A → ʼ | 1,21 | 0,80 |
| ʼ → N | 1,10 | 0,81 |
La G y el signo no llegaron a la meta de 0,45: las detuvo la protección contra toques. Está previsto así: mejor un poco más suelto que un pegado en cuerpo pequeño.
El cirílico: la misma lógica, otro patrón
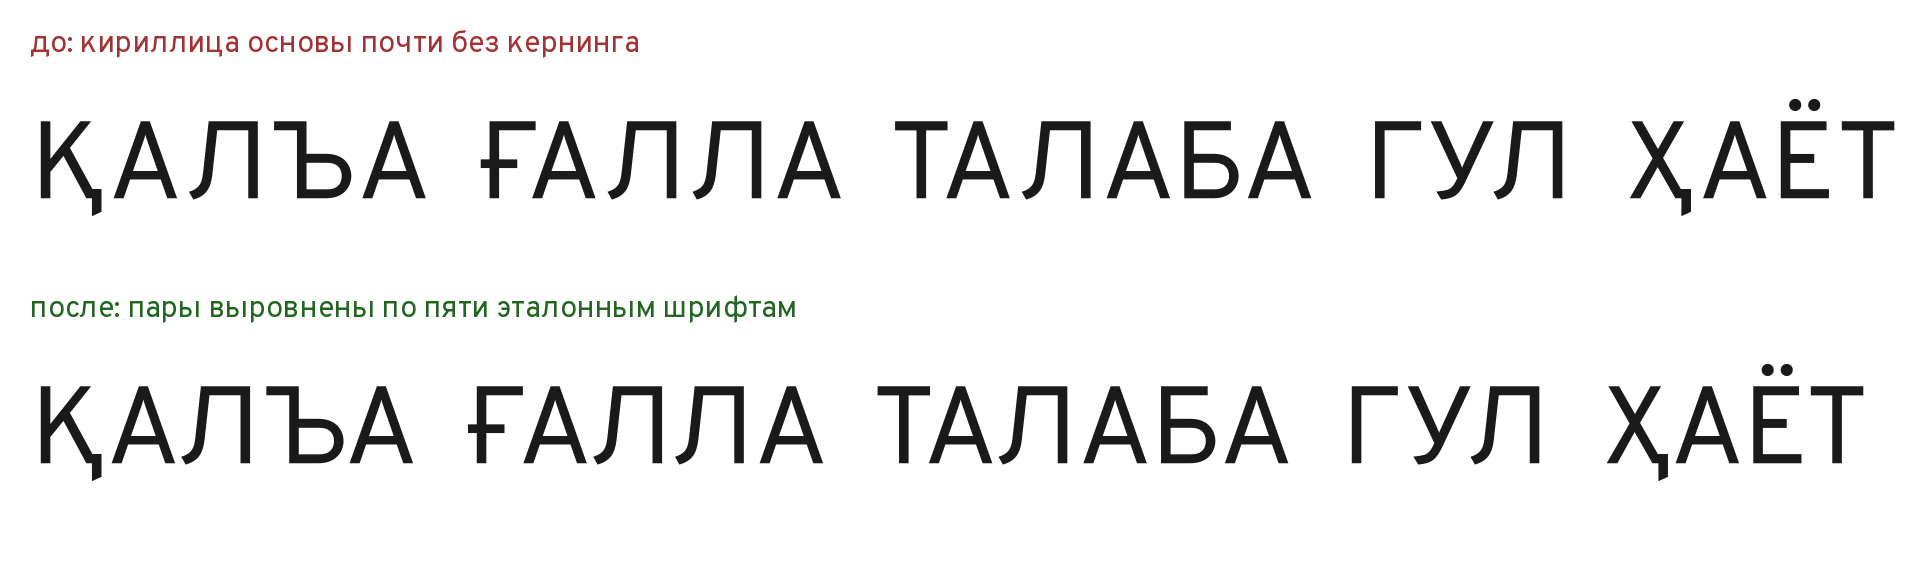
La otra mitad del trabajo fue el cirílico. En Overpass casi no tenía kerning: ГЛ, ТЛ, УА quedaban dispersas, y para Қ Ғ Ҳ no había correcciones en absoluto.
Aquí comparamos Ipak Davlat con cinco tipografías abiertas profesionales: Fira Sans, Inter, Noto Sans, Onest e IBM Plex Sans. Salvedad importante: sus valores de kerning no los copiamos. Medíamos lo apretado que coloca el par cada una respecto a su propio HH, tomábamos la mediana y ajustábamos Ipak Davlat a ella. La mediana es el punto medio de la serie: la mitad de las tipografías coloca el par más apretado y la mitad más suelto. No deja que una sola tipografía inusual descentre el resultado.
Dos reglas simplificaron el trabajo.
Los dobles. Las letras cirílicas iguales en forma a las latinas (А, В, Е, К, М, Н, О, Р, С, Т, Х) se colocan igual que las latinas. El par КА es igual al par KA. Si no, una misma palabra se vería distinta en las dos escrituras.
Las colas. La letra con cola bajo la línea — Қ, Ҳ, Ц, Щ — se coloca como su base: la Қ como la К, la Ҳ como la Х. La cola queda por debajo de la línea y no entra en el hueco.
Aquí ocurrió un error que se encontró en la verificación. La protección contra toques al principio medía solo por encima de la línea, y las colas de Қ y Ҳ casi tocaban la А vecina. La medición se amplió hacia abajo, hasta las colas, y el problema se fue.
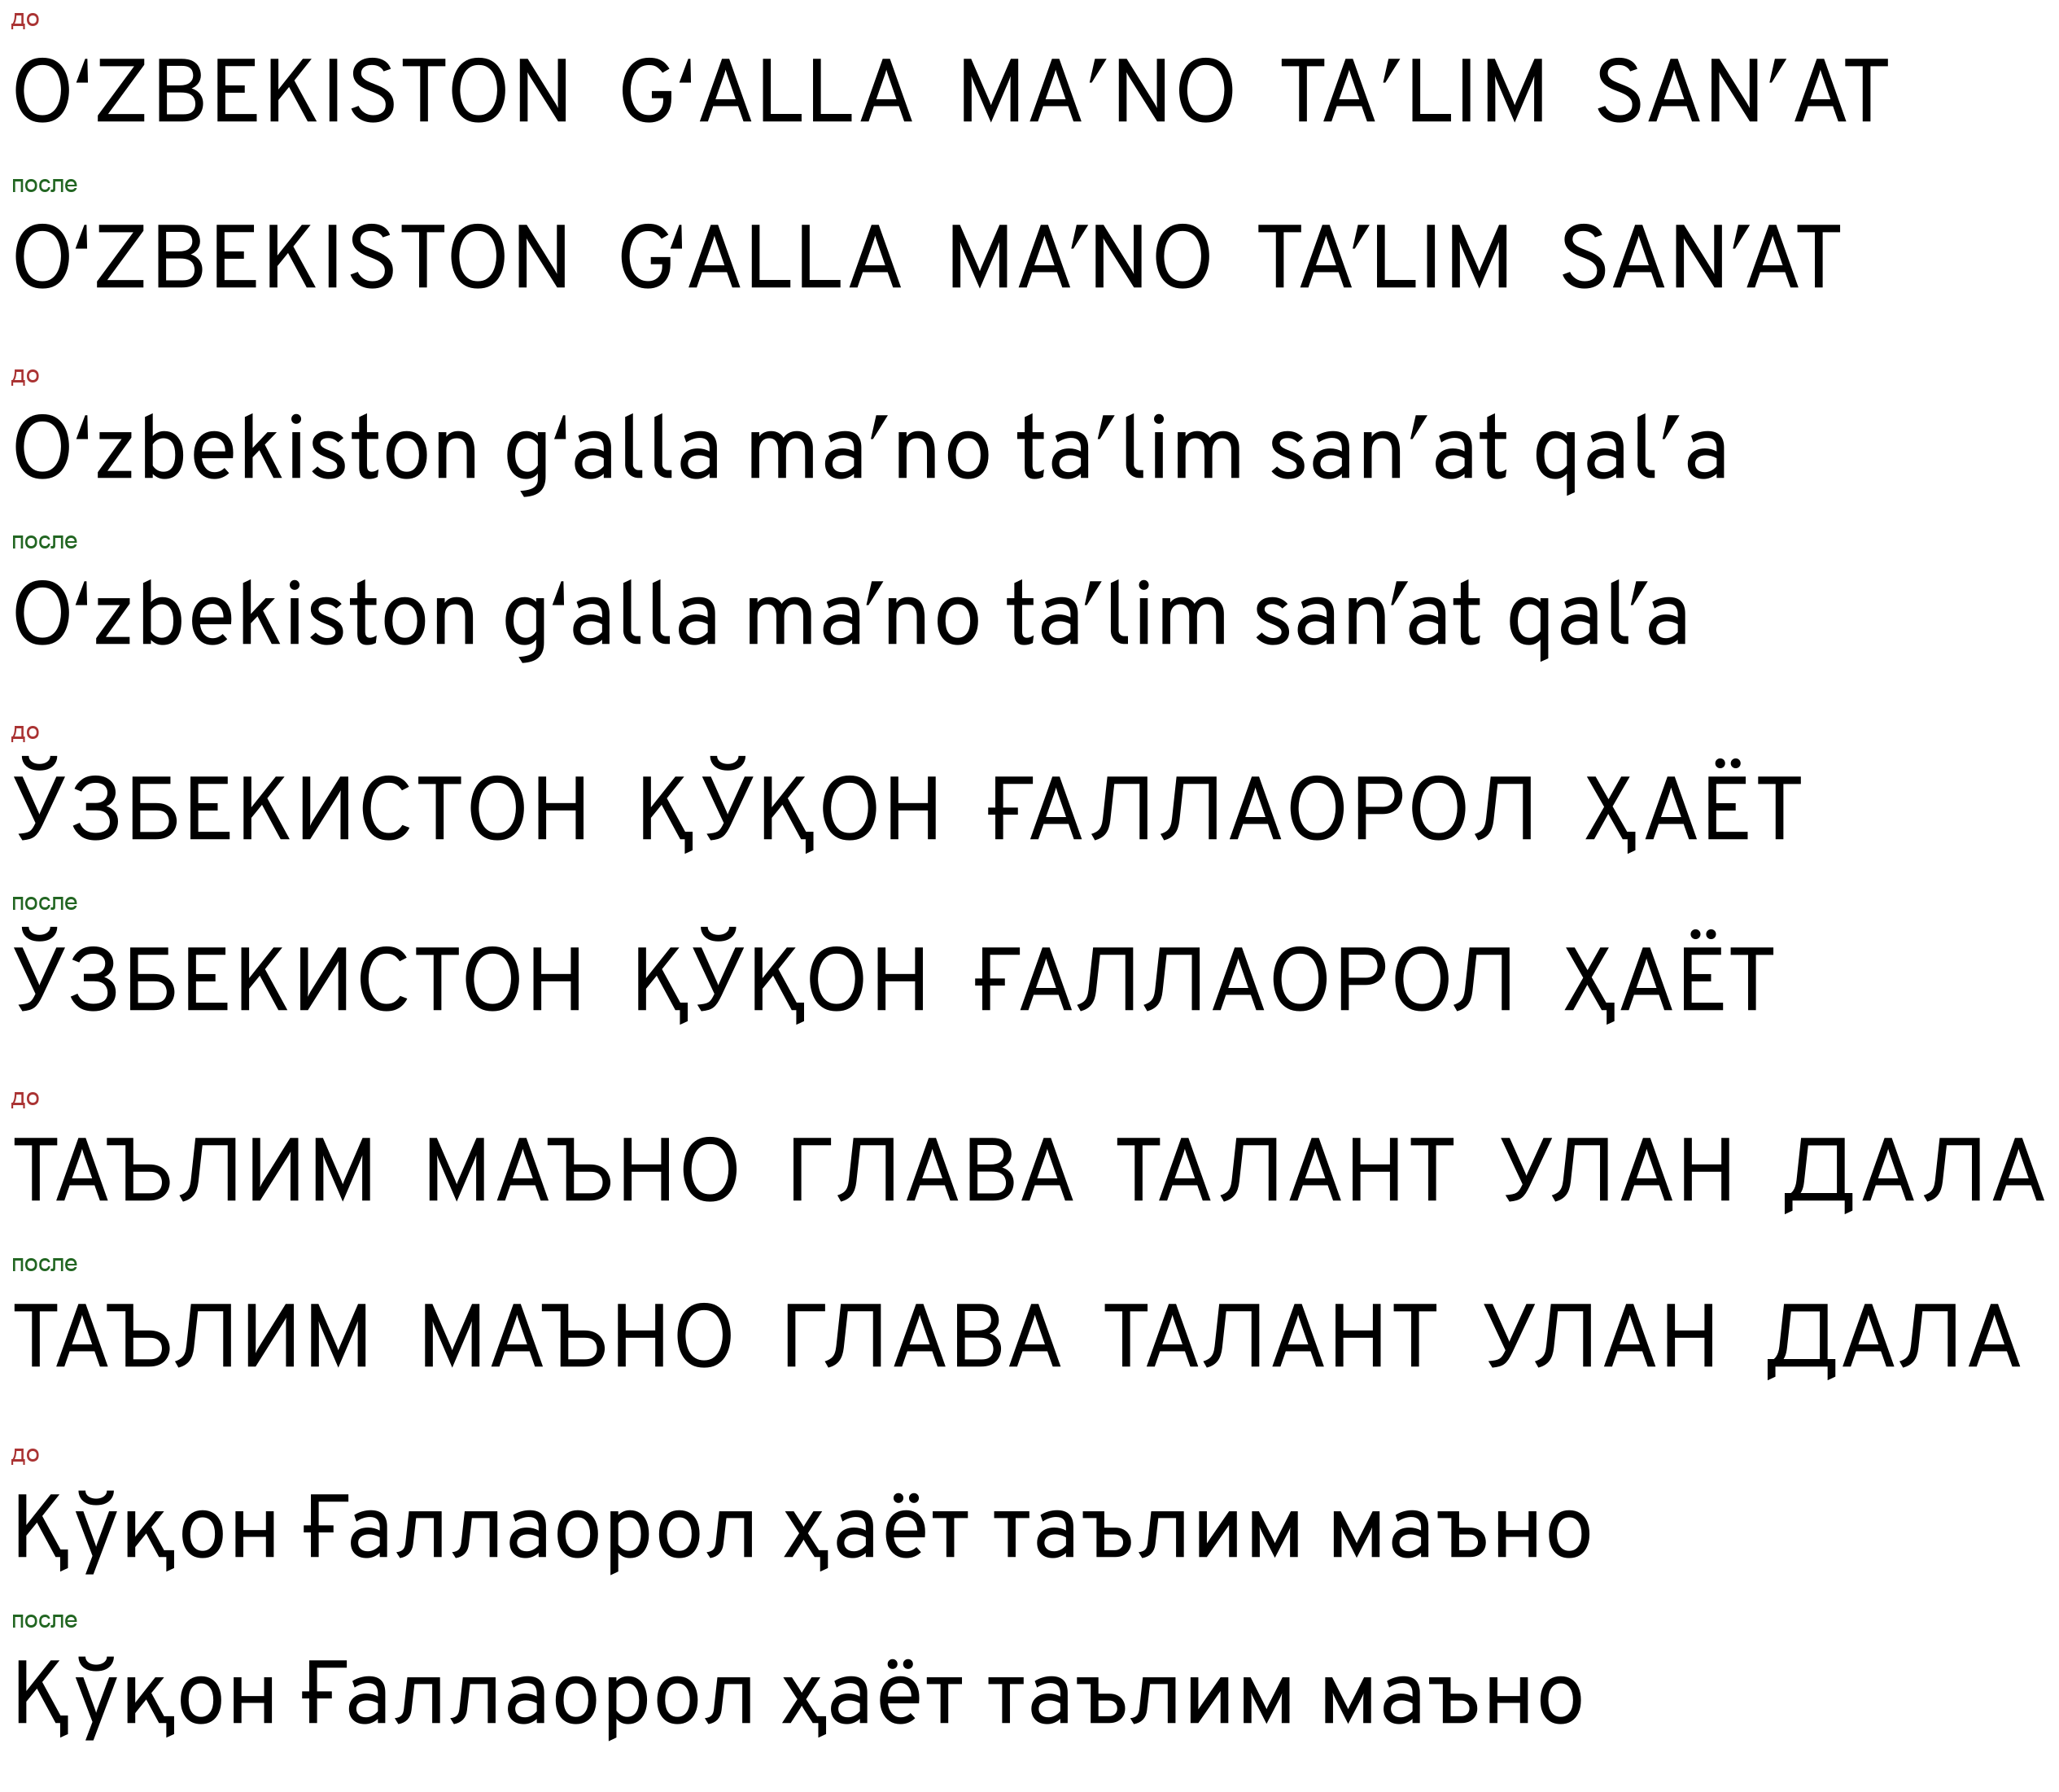
Resultado: 784 pares en Regular y 802 en Bold. La prueba detallada «antes/después», más abajo.
La disputa del toque
En la verificación hubo una observación: el signo de Gʻ casi toca la G, en torno al 1 % del cuerpo. Si eso se hubiera confirmado, la tipografía no se podría publicar.
Lo comprobamos por el contorno: dibujamos el par en un ráster donde el cuerpo equivale a 2000 puntos y medimos la distancia más corta entre la tinta de la G y la del signo. Salió 145 unidades en Regular y 119 en Bold: 7,3 y 6,0 % del cuerpo. Una medición independiente por otro método dio 7,8 y 7,0 %. El umbral que se proponía en la propia observación, 60–80 unidades, se cumple con margen. La observación fue rechazada con cifras. La cercanía del signo a la G aquí no es un error: está pensada así, para que la Gʻ se lea como una sola letra.
Qué se sigue de esto
El signo ʻ no es una comilla, y alinearlo como a una comilla no se puede. Tres conclusiones que servirán a cualquiera que haga una tipografía para el uzbeko:
- El hueco hay que medirlo donde está el signo, y no en toda la altura de la línea.
- El ʻ tiende a su letra; el ʼ se queda en medio: la regla es asimétrica.
- La protección contra toques importa más que una cifra bonita: en cuerpo pequeño, el pegado es peor que el aire de más.
Fuentes
- El consejo sobre el hueco entre O/G y ʻ — А. Шайдуллина, type.today, 04.12.2023.
- Los nombres y números de U+02BB y U+02BC — la tabla de Unicode Spacing Modifier Letters.
- La descripción de la función kern — la especificación OpenType, Microsoft Typography.
- El método y las cifras son nuestros: la medición se hizo con HarfBuzz y FreeType sobre la compilación de Ipak Davlat v0.1, octubre de 2026.
- Las tipografías de referencia: Fira Sans, Inter, Noto Sans, Onest, IBM Plex Sans (todas bajo SIL OFL 1.1).
Enlaces:
- А. Шайдуллина. Uzbek. type.today, 04.12.2023. https://type.today/en/journal/uzbek
- Unicode: Spacing Modifier Letters (U+02B0–U+02FF). https://www.unicode.org/charts/PDF/U02B0.pdf
- OpenType: la función kern (Microsoft Typography). https://learn.microsoft.com/en-us/typography/opentype/spec/features_ko
- HarfBuzz — el motor de composición de texto. https://harfbuzz.github.io/
- Fira Sans. https://github.com/mozilla/Fira
- Inter. https://github.com/rsms/inter
- Noto Sans. https://github.com/notofonts/latin-greek-cyrillic
- Onest. https://github.com/simpals/onest
- IBM Plex. https://github.com/IBM/plex