No alfabeto latino uzbeque há dois sinais especiais. O ʻ, nas letras Oʻ e Gʻ, como em Oʻzbekiston. E o ʼ — o sinal tutuq (tutuq belgisi), sinal separador, como em maʼno. No Unicode, cada um tem o seu número: U+02BB e U+02BC.
Na prática, quase ninguém os digita assim. As pessoas digitam o apóstrofo comum do teclado, ', ou a aspa tipográfica ‘, ou até o acento grave `. Entre os layouts internos do Windows para o uzbeque há apenas o cirílico (Uzbek Cyrillic); não há um layout uzbeque latino, e não existe um meio interno de digitar ʻ (U+02BB). No Word, o sinal pode ser obtido assim: digita-se 02BB e pressiona-se Alt+X.
Por isso, nas placas aparecem todas as variantes ao mesmo tempo. Decidimos que a fonte deve parecer correta independentemente do que foi digitado.
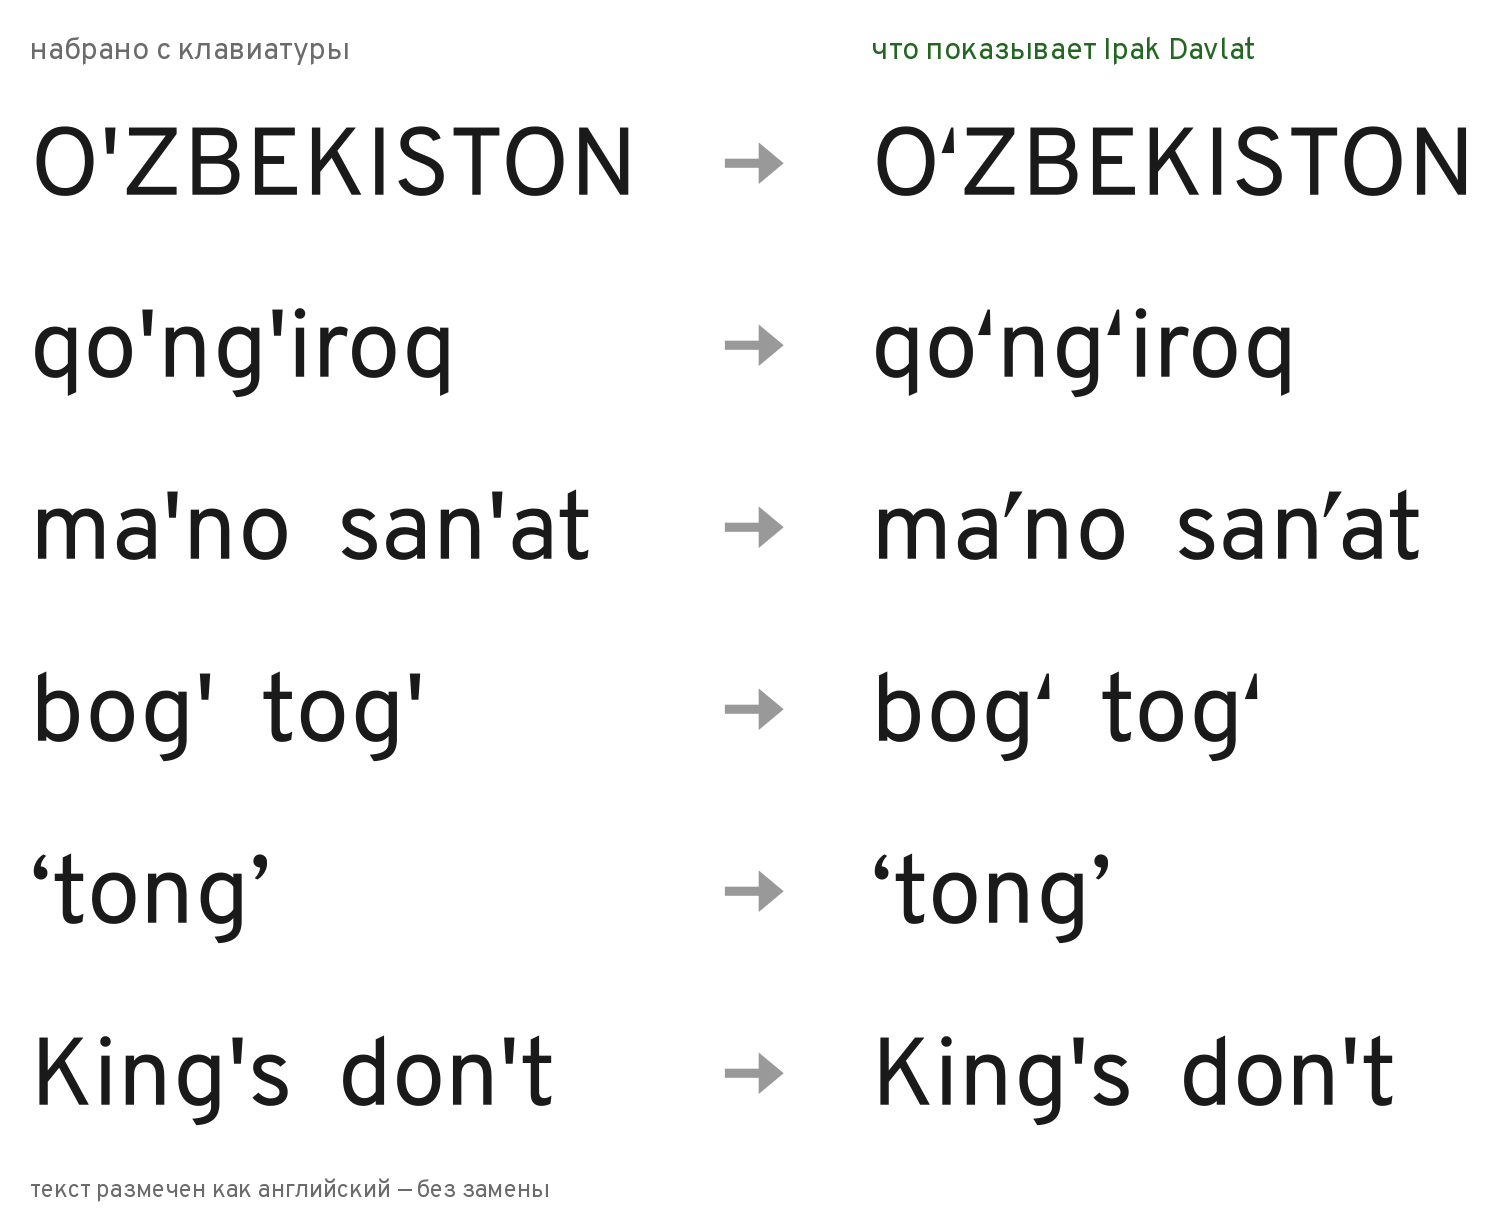
Como funciona
Numa fonte moderna (formato OpenType), além dos desenhos das letras, ficam guardadas regras. Umas movem as letras — é o kerning. Outras trocam um sinal por outro conforme os vizinhos. Essa troca chama-se alternativa contextual, abreviadamente calt.
Os navegadores e muitos programas ativam calt por padrão. O usuário não precisa apertar nada: digita o'zbek e vê oʻzbek.
Sinais próprios
Primeiro desenhamos os sinais em si. A base, a Overpass, não tinha o sinal ʻ, e a sua aspa — uma «gota» redonda — não combinava com os cortes retos das letras.
Os novos sinais são cunhas de cortes retos. A ponta pesada, uma vez e meia o traço; a leve, quase aguda.
- O ʻ tem a massa embaixo e inclinação de 10°.
- O ʼ tem a massa em cima e inclinação de 23°.
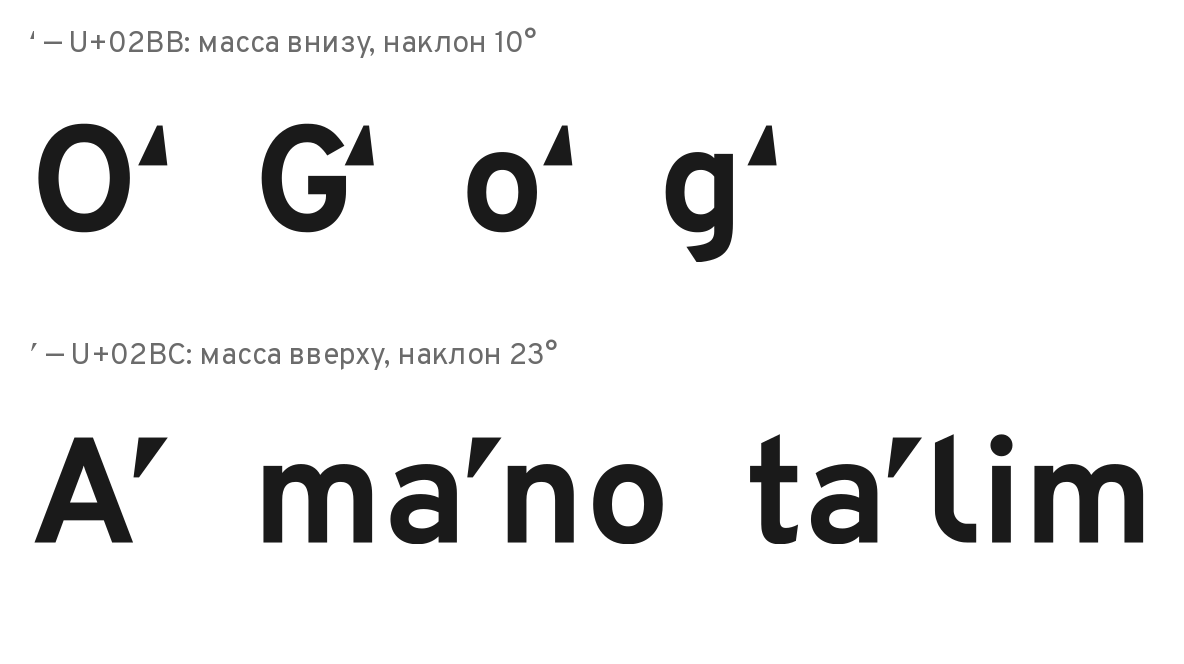
A primeira versão era mais simples: os dois sinais pareciam uma barra oblíqua e diferiam só na espessura das pontas. Na verificação viu-se que, em corpo pequeno, eram indistinguíveis. Agora as silhuetas olham para lados opostos.
As regras
As regras são várias, e a ordem importa: vale a primeira que servir. Elas funcionam para quatro sinais digitados: ' ‘ ’ `.
Depois de O — só dentro da palavra. o'zbek → oʻzbek. Mas em ‘metro’ a aspa de fechar depois do o é aspa, não sinal. Dentro da palavra, depois dela vem uma letra; no fim, não. Esse é o critério.
Depois de G — também no fim da palavra. No uzbeque há muitas palavras terminadas em gʻ: bogʻ, togʻ, sogʻ. Por isso, bog' → bogʻ.
Exceção para o inglês 's. King's, dog's — forma possessiva. Se depois da aspa vem s e a palavra termina, o sinal ʻ não é posto. Mas bog'siz (sem jardim) — dentro da palavra, ali o ʻ é necessário.
ng no fim da palavra. No uzbeque, ng é uma letra só, e ʻ depois dela não existe. Logo, em ‘tong’ a aspa depois de ng é aspa. Dentro da palavra, ao contrário, gʻ depois de n ocorre: qoʻngʻiroq (sino), changʻi (esquis), toʻngʻich (primogênito).
Entre letras — ʼ. Todo o resto que estiver entre duas letras torna-se tutuq: ma'no → maʼno, san'at → sanʼat. No fim da palavra, ʼ não é posto: em man' a aspa permanece.
Idiomas
A regra, útil para o uzbeque, é prejudicial para o inglês. O'Brien não deve virar OʻBrien, nem don't, donʼt.
A fonte pode ativar regras de modo diferente para idiomas diferentes. O idioma vem da marcação do texto: num site, é o atributo lang. Ativamos a substituição para o uzbeque (tag UZB) e para texto sem idioma indicado. Para inglês, alemão, francês, espanhol, italiano, português e russo, ela está desativada. Também está desativada para os idiomas em que a Overpass tem as suas próprias configurações: turco, azerbaijano, cazaque, catalão, neerlandês e outros.
Há aqui uma armadilha, encontrada na verificação. Se a página não indica idioma, o navegador usa o idioma da interface — por exemplo, inglês ou russo. Para eles, a regra está desativada, e o visitante não verá a substituição. Por isso, o conselho: o texto uzbeque no site deve ser marcado — lang="uz".
E no texto não marcado? As regras funcionam. Ali, King's receberá o tutuq ʼ no lugar do apóstrofo: entre g e s está um sinal entre letras. Para um letreiro uzbeque, isso não assusta; já o texto em inglês vale marcar.
Regressão: qoʻngʻiroq
A história mais instrutiva aconteceu na verificação. Regressão é um erro que surge num lugar que já funcionava, depois da correção de outro.
Na verificação pela língua uzbeque viu-se: em ‘tong’ (manhã, entre aspas) a aspa de fechar vira ʻ. Ficava ‘tongʻ. Acrescentamos a regra: depois de ng, não pôr o sinal.
A verificação seguinte encontrou um bloqueador — um erro que impede a publicação da fonte. A regra nova quebrou as palavras em que gʻ vem depois de n dentro da palavra. Depois de ng, passava a valer a regra geral «entre letras», e no lugar de ʻ aparecia ʼ.
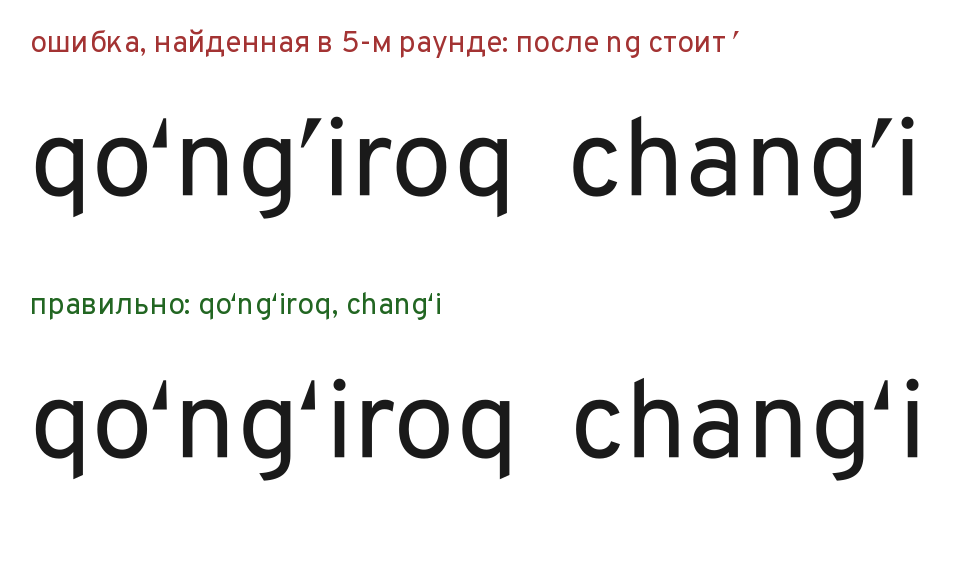
A correção: duas regras em vez de uma. Depois de ng dentro da palavra — ʻ. Depois de ng no fim da palavra — a aspa continua aspa. A ordem das regras importa e está fixada na montagem.
Mas o principal não é a correção. O erro fomos nós mesmos que o introduzimos, ao corrigir outro. Logo, o olho não dá conta dessas coisas. Criamos um teste com palavras reais. Cada caso: o que foi digitado, em que idioma e o que deve resultar. O programa HarfBuzz processa o texto do mesmo jeito que o navegador e compara os sinais escolhidos com os esperados.
Cada observação encontrada sobre a substituição torna-se uma nova linha do teste, e cada caso é verificado nos dois estilos. Todas passam. O teste tem qoʻngʻiroq, ‘tong’, King's e textos marcados como turco, azerbaijano, cazaque, alemão e francês — neles não deve haver substituição.
Limitação conhecida
Um caso a regra, sinceramente, não distingue. Uma palavra emprestada terminada em -g entre aspas, por exemplo 'pedagog', parece igual a bog' para a fonte. A aspa de fechar vira ʻ. Distingui-las só com um dicionário — e a fonte não conhece dicionário. A limitação está fixada no teste, para que o comportamento não mude sem ser notado.
O resultado
A substituição no Ipak Davlat são cinco regras e uma lista de idiomas. O seu valor não está na complexidade, e sim em ter sido verificada com palavras reais: na verificação foram passadas ainda cerca de noventa palavras — Fargʻona, yongʻoq, Qoʻngʻirot, moʻgʻul, musʼhaf, bemaʼni — todas corretas.
O conselho aos usuários é simples. Se puder, digite U+02BB e U+02BC. Se não, digite como está acostumado e marque o texto uzbeque como uzbeque. O resto a fonte faz.
Fontes
- Números e nomes dos símbolos U+02BB, U+02BC, U+2018, U+2019 — tabelas do Unicode.
- Os layouts do Windows — a lista da Microsoft «Keyboard identifiers and input method editors for Windows».
- O recurso calt e a tag de idioma UZB — especificação OpenType, Microsoft Typography.
- calt nos navegadores: o valor
normaldefont-variant-ligaturescostuma ativar as formas contextuais — MDN. - O atributo
lang— MDN. - As regras, os idiomas e o teste são nossos: montagem do Ipak Davlat v0.1, outubro de 2026.
Links:
- Unicode: Spacing Modifier Letters (U+02BB, U+02BC). https://www.unicode.org/charts/PDF/U02B0.pdf
- Unicode: General Punctuation (U+2018, U+2019). https://www.unicode.org/charts/PDF/U2000.pdf
- Microsoft: Keyboard identifiers and input method editors for Windows. https://learn.microsoft.com/en-us/windows-hardware/manufacture/desktop/windows-language-pack-default-values
- Gʻ — Wikipedia. https://en.wikipedia.org/wiki/Gʻ
- Uzbek alphabet — Wikipedia. https://en.wikipedia.org/wiki/Uzbek_alphabet
- OpenType: o recurso calt (Microsoft Typography). https://learn.microsoft.com/en-us/typography/opentype/spec/features_ae
- OpenType: tags de idioma (UZB — uzbeque). https://learn.microsoft.com/en-us/typography/opentype/spec/languagetags
- MDN: font-variant-ligatures (contextual = calt). https://developer.mozilla.org/en-US/docs/Web/CSS/font-variant-ligatures
- MDN: o atributo lang. https://developer.mozilla.org/en-US/docs/Web/HTML/Global_attributes/lang
- HarfBuzz — motor de layout de texto. https://harfbuzz.github.io/